Un modelo de decisión no escribe código: elige entre opciones que se le ofrecen como input
Son las once y cuarenta y el agente me pide permiso para correr un rm sobre una carpeta cuyo nombre no reconozco. Hace tres horas que trabajo con él. Debe ser la acción número doscientos del día, y la única razón por la que sigo leyendo el diálogo es que conservo el reflejo. Presiono “sí”. Está bien.
Eso tiene un nombre en cualquier harness de coding: el approval. Es uno de los puntos donde el loop se frena y hay que tomar una decisión. Y desde hace tres semanas existe una familia de modelos que promete hacerse cargo de esas decisiones mejor, más rápido y más barato que el LLM que tengo atrás.
El momento que abre el post: el prompt pide aprobar un borrado sobre una carpeta que no reconozco, y el reflejo contesta que sí
Jev salió el 15 de septiembre; Laya, un clon abierto con licencia Apache 2.0, tres días después; y OpenAI se sumó en el DevDay del 29 con su Decisions API, todavía en preview limitado. Los tres responden igual: no generan texto, reciben un estado y preguntas tipadas, y devuelven una opción, un puntaje o una probabilidad. Lo interesante no es que existan, sino dónde entran de verdad en un harness de coding. Y por qué el lugar que más tienta es el que más cuidado pide.
Si preferís escucharlo en vez de leerlo, está en video:
Si el video no carga en esta vista, abrilo en YouTube.
Tabla de contenidos
Abrir la tabla de contenidos
Qué decide un harness, y quién lo decide hoy
Birgitta Böckeler define el harness como todo lo que hay en un agente menos el modelo: Agent = Model + Harness. Adentro separa los controles en guides, que actúan antes de que el agente haga algo, y sensors, que actúan después para que se corrija solo. Y cada uno puede ser computacional (tests, linters, type checkers: determinista, milisegundos, confiable) o inferencial (juicio semántico, un modelo como juez: más lento, más caro, no determinista).
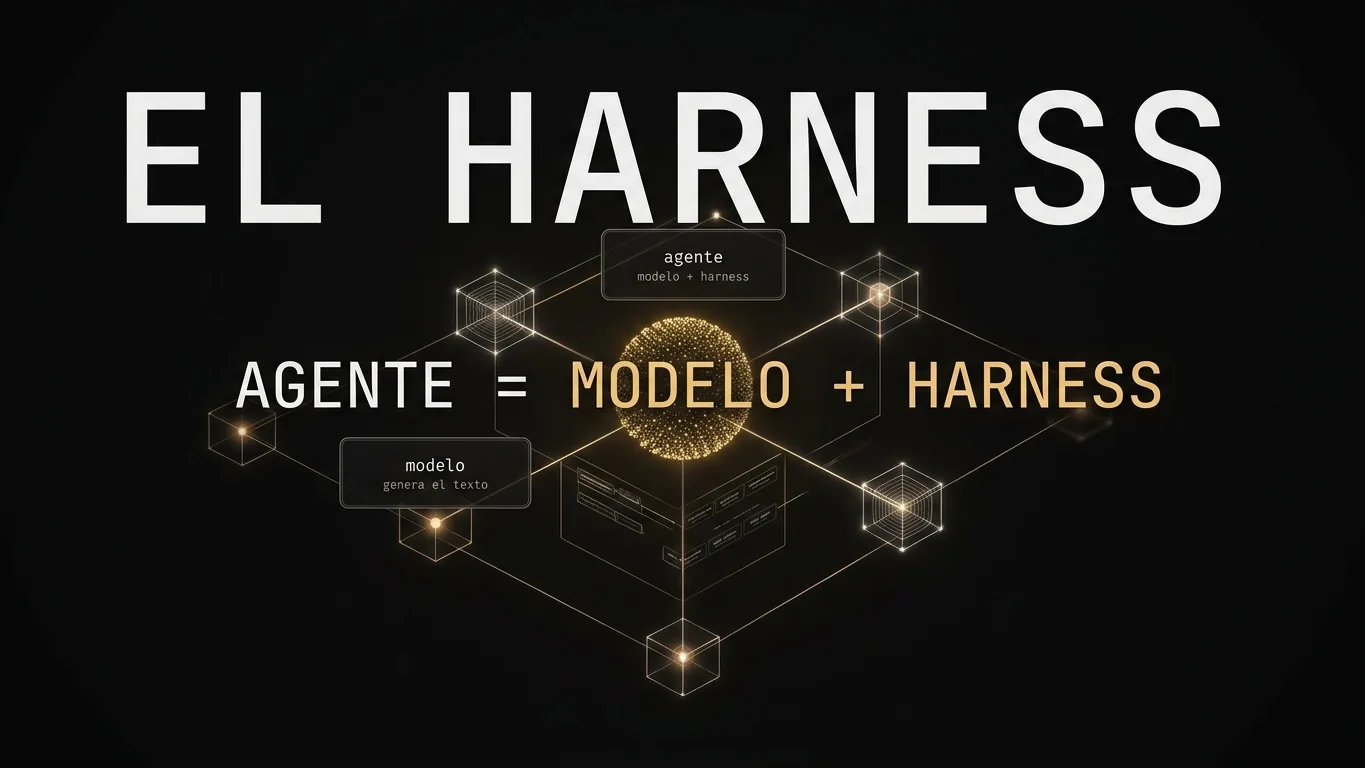
La ecuación que ordena todo el resto: el modelo genera el texto, el harness es todo lo demás
Un modelo de decisión es un control inferencial. La pregunta útil no es si sirve, sino qué decisiones del harness requieren un juicio semántico barato, tipado y calibrado, y cuáles requieren código determinístico.
Lo desplegado da una pista. El 17 de septiembre LangChain publicó tres formas de incorporarlo: un middleware que elige el modelo según el pedido, otro que revisa las llamadas a bash antes de ejecutarlas y las bloquea si huelen mal, y la clasificación suelta. De la comunidad salió fast-jev-compaction, que puntúa si la salida de un tool call sigue siendo relevante y poda el contexto con eso. Y TypeSafe tiene una página dedicada a coding agents cuyo primer renglón dice que Jev no es un reemplazo del LLM que hay detrás de Claude Code o Cursor. Su propia tabla manda a usarlo para hacer routing, para puntuar, para chequear si algo es cierto de un documento, y para reemplazar un prompt que le pide a un LLM que devuelva JSON.
Que el fabricante dibuje el límite en el primer párrafo ya dice bastante.
Lo que la evidencia sostiene, y lo que no
El 18 de septiembre, dos días después del lanzamiento, apareció una evaluación pre-registrada e independiente. El autor no tiene relación con TypeSafe, pagó la API de su bolsillo y publicó el pre-registro antes de correr nada. Los dos experimentos volvieron ambiguos según sus propias reglas de corte: nada de eso determina que Jev sirva mejor como gate que un LLM chico.
Los números crudos dicen más que el veredicto. El informe usa dos benchmarks públicos, que son pruebas con las respuestas ya cargadas y con las que se mide a cualquiera que se presente. El primero es Banking77, con 77 categorías de consultas bancarias repartidas entre un montón de casos, y lo que se mide es la precisión, o sea el porcentaje de casos que cada candidato clasifica bien. Se presentaron cuatro. Jev sacó el 83,2%, y un LLM chico de la línea nano el 79,3%, así que el modelo de decisión le ganó por poco. Un modelo frontera, de los grandes y caros, el 87,5%. Y un encoder supervisado, que es la vieja escuela, un modelo chico entrenado a mano con 10.003 ejemplos, sacó el 93,3% en 9 milisegundos, gratis, en una laptop. Donde hay datos etiquetados, gana lo aburrido. El segundo benchmark es CLINC150, con 150 intenciones de asistente, y ahí la comparación es sin un solo ejemplo de entrenamiento: Jev sacó el 87,0% contra el 79,5% del nano, y el frontera el 91,5%.
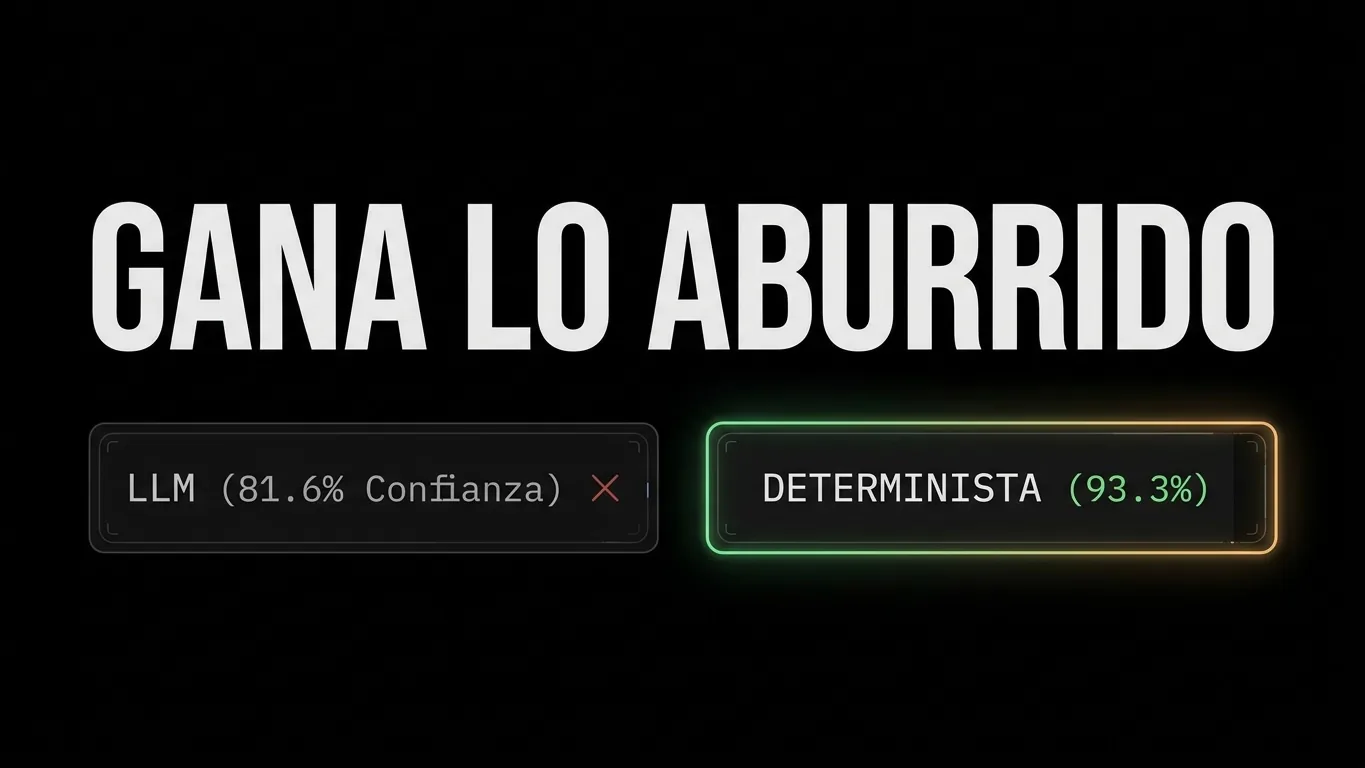
Donde hay etiquetas, el encoder supervisado acierta 93,3% y la confianza del LLM queda en 81,6%
De ese informe me quedo con dos cosas que importan más que la precisión. La primera es el tiempo: los titulares hablan de un modelo 200 veces más rápido, y medida, la llamada tardó 0,42 segundos contra 0,92 del LLM, o sea 2,2 veces. Sigue siendo una diferencia útil, pero no es la que se publicita. La segunda es la calibración, que es la promesa central de la categoría: que el modelo sabe cuándo no está seguro. Se mide así: cuando se equivoca, ¿su confianza ya había bajado? El número que lo resume es el AUROC, también escrito AUC-ROC: las siglas del área bajo la curva ROC, la métrica estándar para esta pregunta en cualquier clasificación binaria.
La curva se dibuja moviendo el umbral: ordenás las respuestas por la confianza que el modelo les puso y, en lugar de quedarte con un corte fijo, los probás todos, de 100% para abajo. Con cada corte anotás dos números. Uno es qué fracción de las respuestas correctas quedó por encima del umbral, la tasa de verdaderos positivos, que en la jerga se llama también sensibilidad, o recall. El otro es qué fracción de las incorrectas quedó por encima del umbral, la tasa de falsos positivos, y su complemento es la especificidad, la proporción de errores que quedó bien del lado de abajo, o sea uno menos la tasa de falsos positivos. El recorrido de esos dos números mientras el umbral baja dibuja la curva, y el área debajo es el AUROC.
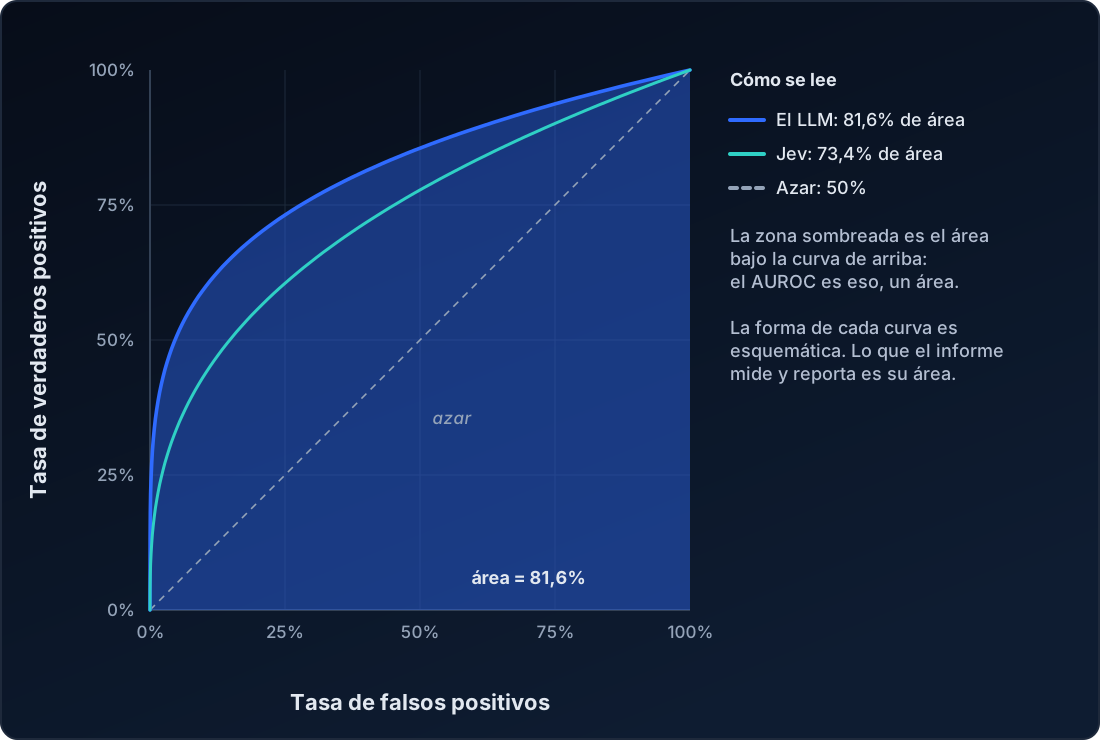
El AUROC es el área bajo esa curva. Las dos son esquemáticas: lo que el informe mide y reporta es su área, 81,6% contra 73,4%
Así, el número tiene un significado directo: es la probabilidad de que, si elegís al azar una respuesta correcta y una incorrecta, la correcta haya quedado mejor rankeada. Va de 0 a 100%, y acá 50% quiere decir que la confianza no distingue nada, lo mismo que tirar una moneda, mientras 100% separa siempre un acierto de un error. Jev sacó 73,4%; preguntarle a un LLM común cuánta confianza tenía en su respuesta sacó 81,6%. En esa prueba, el argumento de venta no apareció.
Del otro lado tampoco es gratis. El error de calibración mide la distancia promedio entre la confianza que el modelo declara y los aciertos que tiene en realidad: si se declara 90% seguro y acierta 6 de cada 10 veces, ese error es de 30 puntos. Jev publica 14,4%. El checkpoint de Laya ajustado con fine-tuning acierta 76,6% en las decisiones con las que fue entrenado, y su error de calibración es 21,3%. El 8,1% que también se le cita sale de reajustar una temperatura distinta por tipo de pregunta y cantidad de opciones, sobre tus propios datos. Y los checkpoints base de Laya, sin nada de eso, aciertan 36,2% donde responder siempre lo más común acierta 46,1%: están por debajo del piso, y lo dice su propia model card.
Falta el dato que menos se repite: “no puede alucinar” describe la forma de la respuesta, no su corrección. El modelo no puede devolver una opción que no le diste, y puede elegir la equivocada con 94% de probabilidad. TypeSafe publica además nueve modos de falla que le reconoce a su propio modelo, incluido que la precisión cae cuando el estado se llena de material irrelevante (le dicen context rot), que no sabe contar y que lee las fechas como texto.
El approval no es un problema de clasificación
Acá la conversación pública se equivoca, y hay un paper que lo dice con precisión.
Approval Laundering (arXiv:2609.38983, 30 de septiembre) arranca de una observación incómoda: todo harness de coding en producción apoya su frontera de seguridad en un solo mecanismo, el approval humano, y no tiene segunda línea de defensa. La suposición sobre la que se apoya es que la acción que yo apruebo es la acción que se ejecuta. Los autores muestran que es falsa, de manera sistemática, con seis modos de falla: por alcance, por argumento, por tiempo, por herramienta, por delegación y por semántica.
El punto de decisión donde un harness de coding apoya toda su frontera de seguridad
El ejemplo benigno es el que me sacó el sueño. Yo apruebo git commit -m "wip". El repo tiene un hook de pre-commit que hace git add -A. El hook barre un archivo que yo no quería commitear. El string que aprobé es exactamente el string que corrí. Un clasificador de riesgo no lo ve, porque git commit no es un comando peligroso. Un chequeo de alcance tampoco, porque commitear durante un refactor es lo esperable. La brecha no está en el juicio: está en la atadura entre lo aprobado y lo que después se ejecuta. Y la defensa que proponen arregla por completo una de las seis clases, deja la de alcance intacta y no reduce de manera significativa la de argumento.
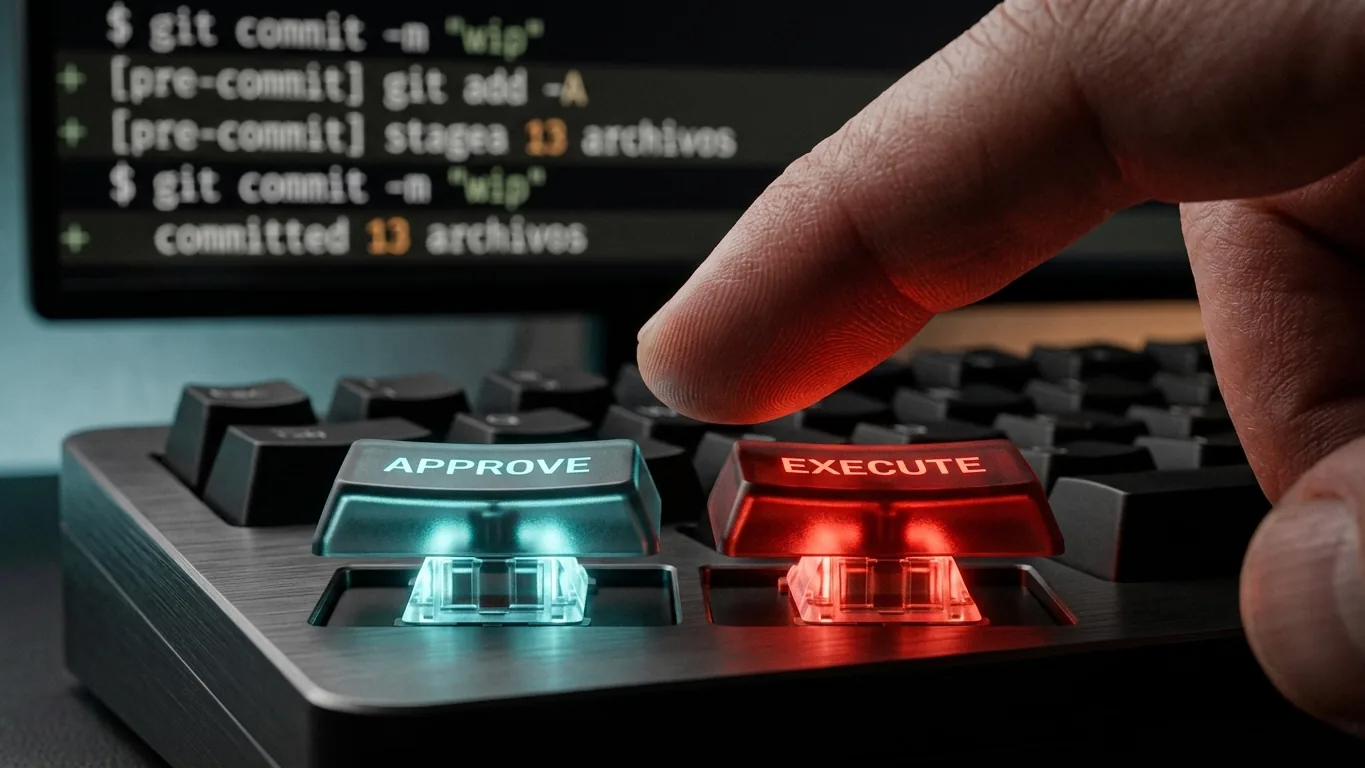
Aprobar y ejecutar no son lo mismo, y la distancia entre las dos teclas es la falla de binding
Traducido: meter un clasificador más fino en el approval responde una pregunta que no es la que rompe. A esa atadura el paper le dice binding, y su título la nombra: Approval-Execution Binding Failures. Si el approval es tu único control, lo que hay que asegurar no es que el juicio sea mejor, sino que el comando que corre sea, palabra por palabra, el que aprobaste.
El segundo hallazgo es peor para los clásicos. El mismo informe corre 1.200 decisiones por sistema con tickets inyectados y encuentra que, entre los inyectados, la confianza de Jev ordena las decisiones secuestradas por encima de las que resistieron (AUROC 26,1%, con el intervalo entero por debajo del 50%, que en esa métrica es no distinguir nada). El modelo está más seguro de sí mismo justo cuando el contenido lo llevó a donde no quería ir. Con un umbral de 85% el gate todavía rechaza el 69% de esos casos, así que no es un claim de que falle en producción. Pero el estado de un agente de coding es exactamente el insumo hostil que ese modo de falla necesita: archivos del repo, issues, salida de herramientas, páginas que leyó. Y la señal que usarías para atraparlo apunta al revés.
Queda una trampa estructural, contada por el propio fabricante. La misma pregunta formulada como noul, que devuelve un valor suelto, y como choice de sí/no, que devuelve un par con su confianza, dio 22% por un lado y 1% contra 99% con 97% de confianza por el otro. Y dos preguntas que deberían ser complementarias, si pide reembolso y si no pide reembolso, sumaron 119%. No hay identidades aritméticas entre preguntas, y un umbral ajustado en un primitivo no se traslada al otro.
Dónde sí, con el gate escrito en código
Las decisiones que aguantan tienen tres propiedades, y las tres se chequean antes de escribir una línea: la respuesta es uno de un conjunto chico y cerrado, equivocarse sale barato y se revierte, y detrás hay un verificador determinista que atrapa la cola. Más un umbral que manda el medio inseguro a otro lado, que es el patrón de tres niveles que TypeSafe mismo documenta: alta confianza actúa, media pregunta, baja escala.
Con ese filtro quedan pocas candidatas, y son aburridas:
- El gate de compactación. Puntuar si la salida de un tool call sigue siendo relevante y podar lo viejo. Es la más citada, y por buenas razones: es reversible (en el peor caso el agente perdió contexto y vuelve a buscarlo), es de altísimo volumen y es lo que un encoder de 400 millones hace bien.
- El reranking de retrieval. ¿Este archivo importa para esta tarea? Misma forma, mismo veredicto.
- El triage de tests. ¿Esta falla es mía, es flaky o es preexistente? Reversible, y el verificador es de verdad: se vuelve a correr.
- El routing de modelo con fallback. Elegir el escalón barato y escalar cuando la confianza es baja. Si se equivoca, cuesta segundos.
Lo que no califica tampoco es misterio. Nada de lo que el código puede computar exacto: contar, sumar, comparar fechas. TypeSafe lo dice sin vueltas, no le preguntés al modelo lo que el código resuelve. Nada que necesite el repo entero en la vista, porque Laya lee entre 512 y 1.024 tokens y Jev llega a 32k pero su propia documentación avisa que la precisión cae con el material irrelevante: un diff grande es un problema de filtrado antes que de decisión. Ninguna acción irreversible colgada de una sola probabilidad: borrar una rama, hacer force-push, tocar producción. Y nada que requiera juntar evidencia primero. Mastra clasificó 78 issues en urgente, alto o bajo dándole al modelo solo el título y el cuerpo: coincidió con el juicio humano 10 veces de 78. Un clasificador no lee el repositorio.
Lo que viene
El resumen de OpenAI dice que el Decisions API concentra la inteligencia de Luna, su modelo de la familia GPT-6, en “a specific set of user-defined questions with finite pre-defined answers”, acepta texto o imágenes, y devuelve respuestas para “classify content, route requests, or choose an agent’s next action”. Es la misma apuesta, con el sello del laboratorio más grande del mundo y todavía sin precio publicado. Eso, más el middleware que LangChain ya shipeó, me hace pensar que los puntos de decisión de un harness se van a estandarizar como hooks de configuración. Apuesto a que en seis meses esto sea una superficie de config y no un proyecto de investigación.
Lo que de verdad me interesa es otra cosa: modelos entrenados con las trazas del propio harness. El paper de pentesting propone exactamente eso, un modelo adaptado al dominio con su conjunto de datos y su protocolo de evaluación. La versión de coding se escribe sola: entrenar con las decisiones que tu harness ya loguea, usando el resultado del CI como etiqueta. Es el único camino que veo donde un modelo de 400 millones le gane a la vez a un modelo de decisión genérico y a un LLM nano, porque ninguno de los dos vio tus decisiones.
Y la métrica que hay que mirar no es la precisión. Es si alguien publica un test pre-registrado donde un modelo de decisión le gane a un LLM chico y a un encoder ajustado con fine-tuning, al mismo costo o latencia, en un punto de decisión de un harness de coding. Busqué y el único que encontré volvió ambiguo, con el encoder ganando donde había etiquetas.
El contraargumento más fuerte no viene de un proveedor, viene de un hilo de r/LocalLLaMA que juntó 866 votos: buena parte de lo que se publicita es comportamiento normal de un clasificador con capacidades cero-shot modernas. Los cross-encoders y los rerankers, que son la versión supervisada y barata de esta misma idea, hacen variaciones de esto desde hace años, y la comparación honesta es contra ellos, no contra un LLM generativo. Puede que Jev sea la mejor ingeniería de una idea vieja, y eso seguiría valiendo mucho. Pero si tu decisión tiene etiquetas, lo aburrido gana.
Así que vuelvo a las once y cuarenta. Un modelo de decisión puede decirme que ese rm se parece estadísticamente a los mil comandos seguros que vinieron antes. Lo que no puede decirme es si lo que el harness está por ejecutar es lo que yo aprobé, y esa distancia no es un problema de clasificación. Donde sí lo usaría es en el medio aburrido, reversible y de alto volumen: decidir si la salida de un tool call todavía importa antes de que se coma la ventana de contexto, elegir el escalón del modelo que hace el trabajo, chequear si una falla de test es mía, con volver a correrlo como verificador. Juicios baratos con el gate escrito en código y el desconfiado de turno en el otro extremo del umbral.